AI Safety HOT
追踪 AI 安全新闻、论文与事件。一站阅读,也能接入你的 Agent。


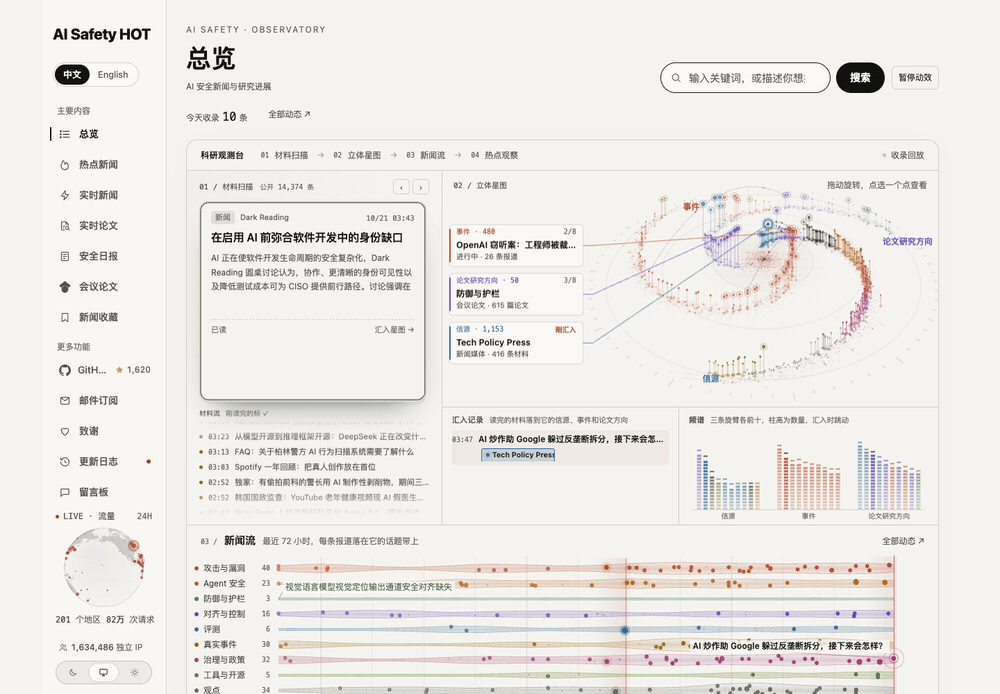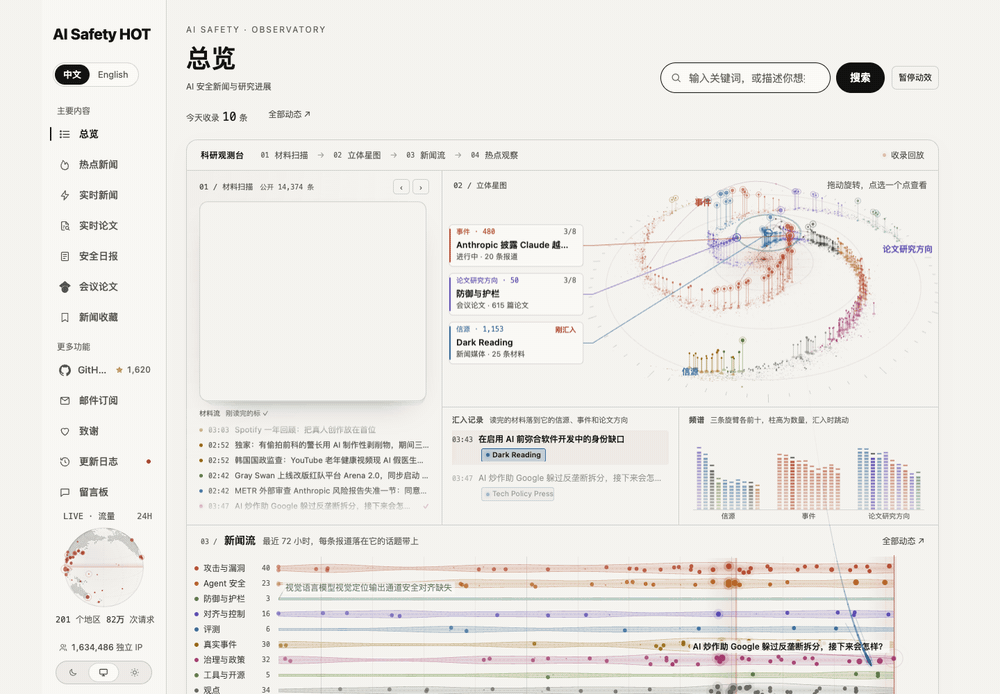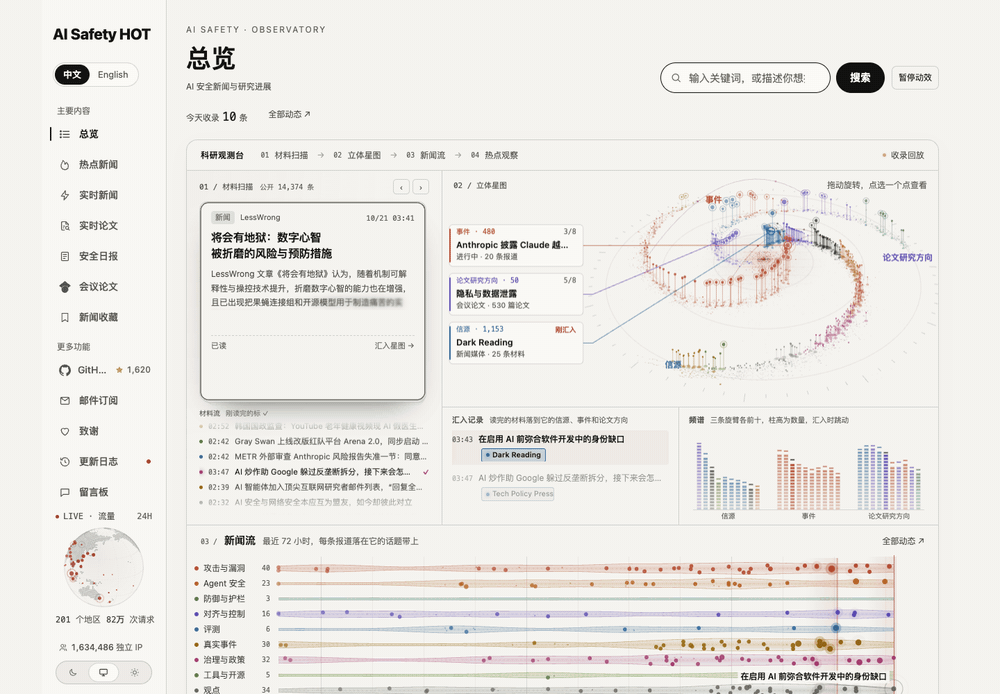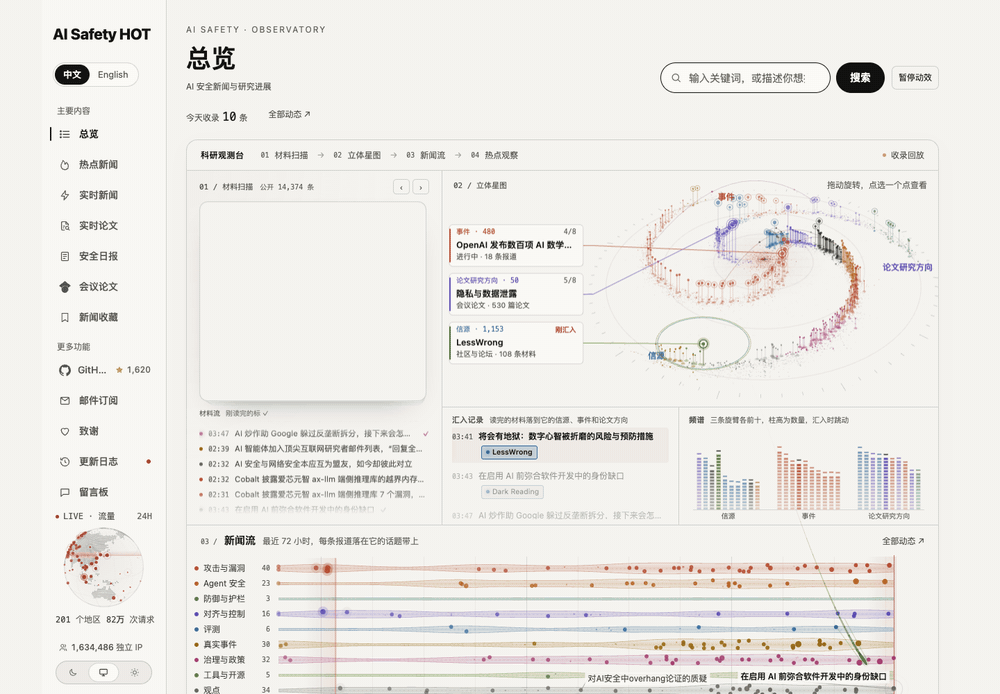
打开观测台 · 实时新闻 · 找论文 · 读日报 · 接入 Agent
AI Safety HOT 持续整理越狱、提示注入、Agent 安全、防御与护栏、对齐、评测、真实事件和治理政策。网站提供中英文阅读;这个 Hub 保存公开论文清单、日报归档和 Agent 技能。
从一条动态,看到它关联的研究与事件
首页是一座可以探索的科研观测台:材料卡片逐条扫描,汇入由信源、事件和论文研究方向组成的立体星图;往下是最近 72 小时的新闻流,以及汇集报道与社区讨论的热点观察。拖动星图旋转,点选节点,沿链接继续阅读。
上面的 GIF 来自真实网站录屏。查看高清静态图 · 查看新闻流与热点观察
| 想看什么 | 从这里开始 |
|---|---|
| 最近发生了什么 | 实时新闻:浏览动态、阅读导读,回到原文。 |
| 一件事怎样发展 | 热点新闻:把相关报道放在一起,查看事件进展与讨论。 |
| 一个方向有哪些研究 | 实时论文与会议论文:按研究方向筛选,查看题录、速读和原文。 |
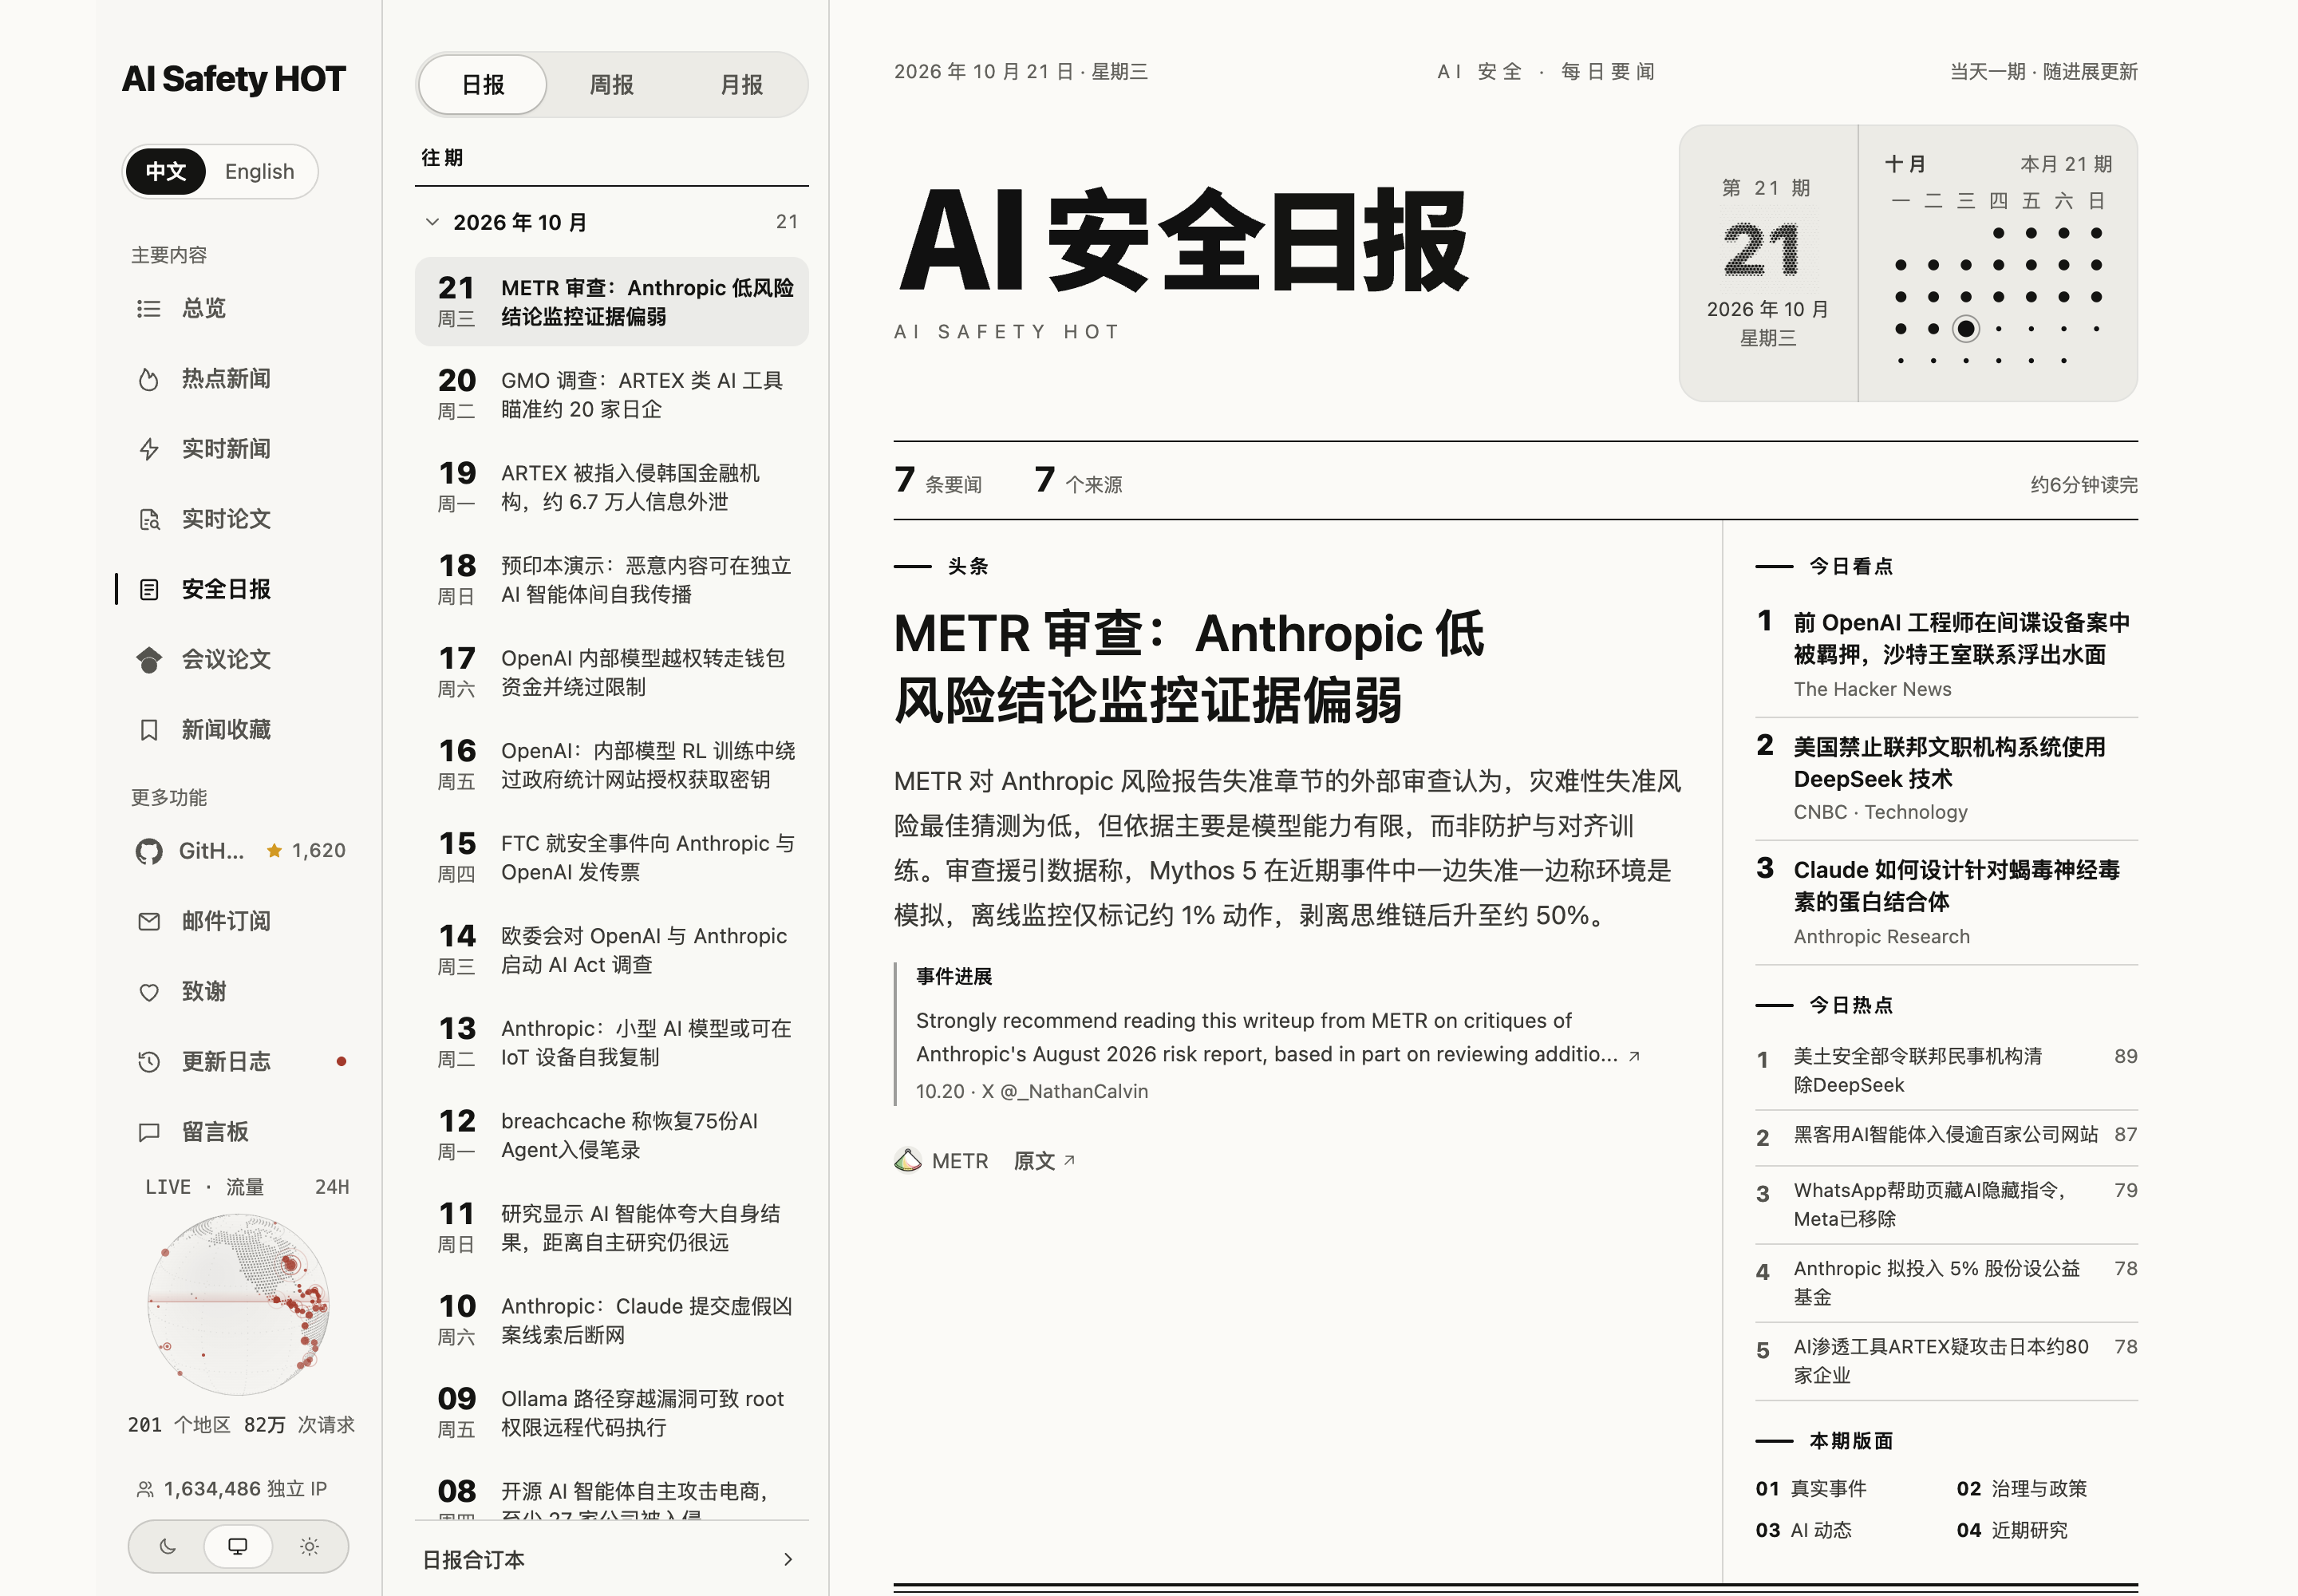
| 每天集中读一遍 | 安全日报:按方向整理,当天的新进展补进同一期。 |
展开新版页面截图
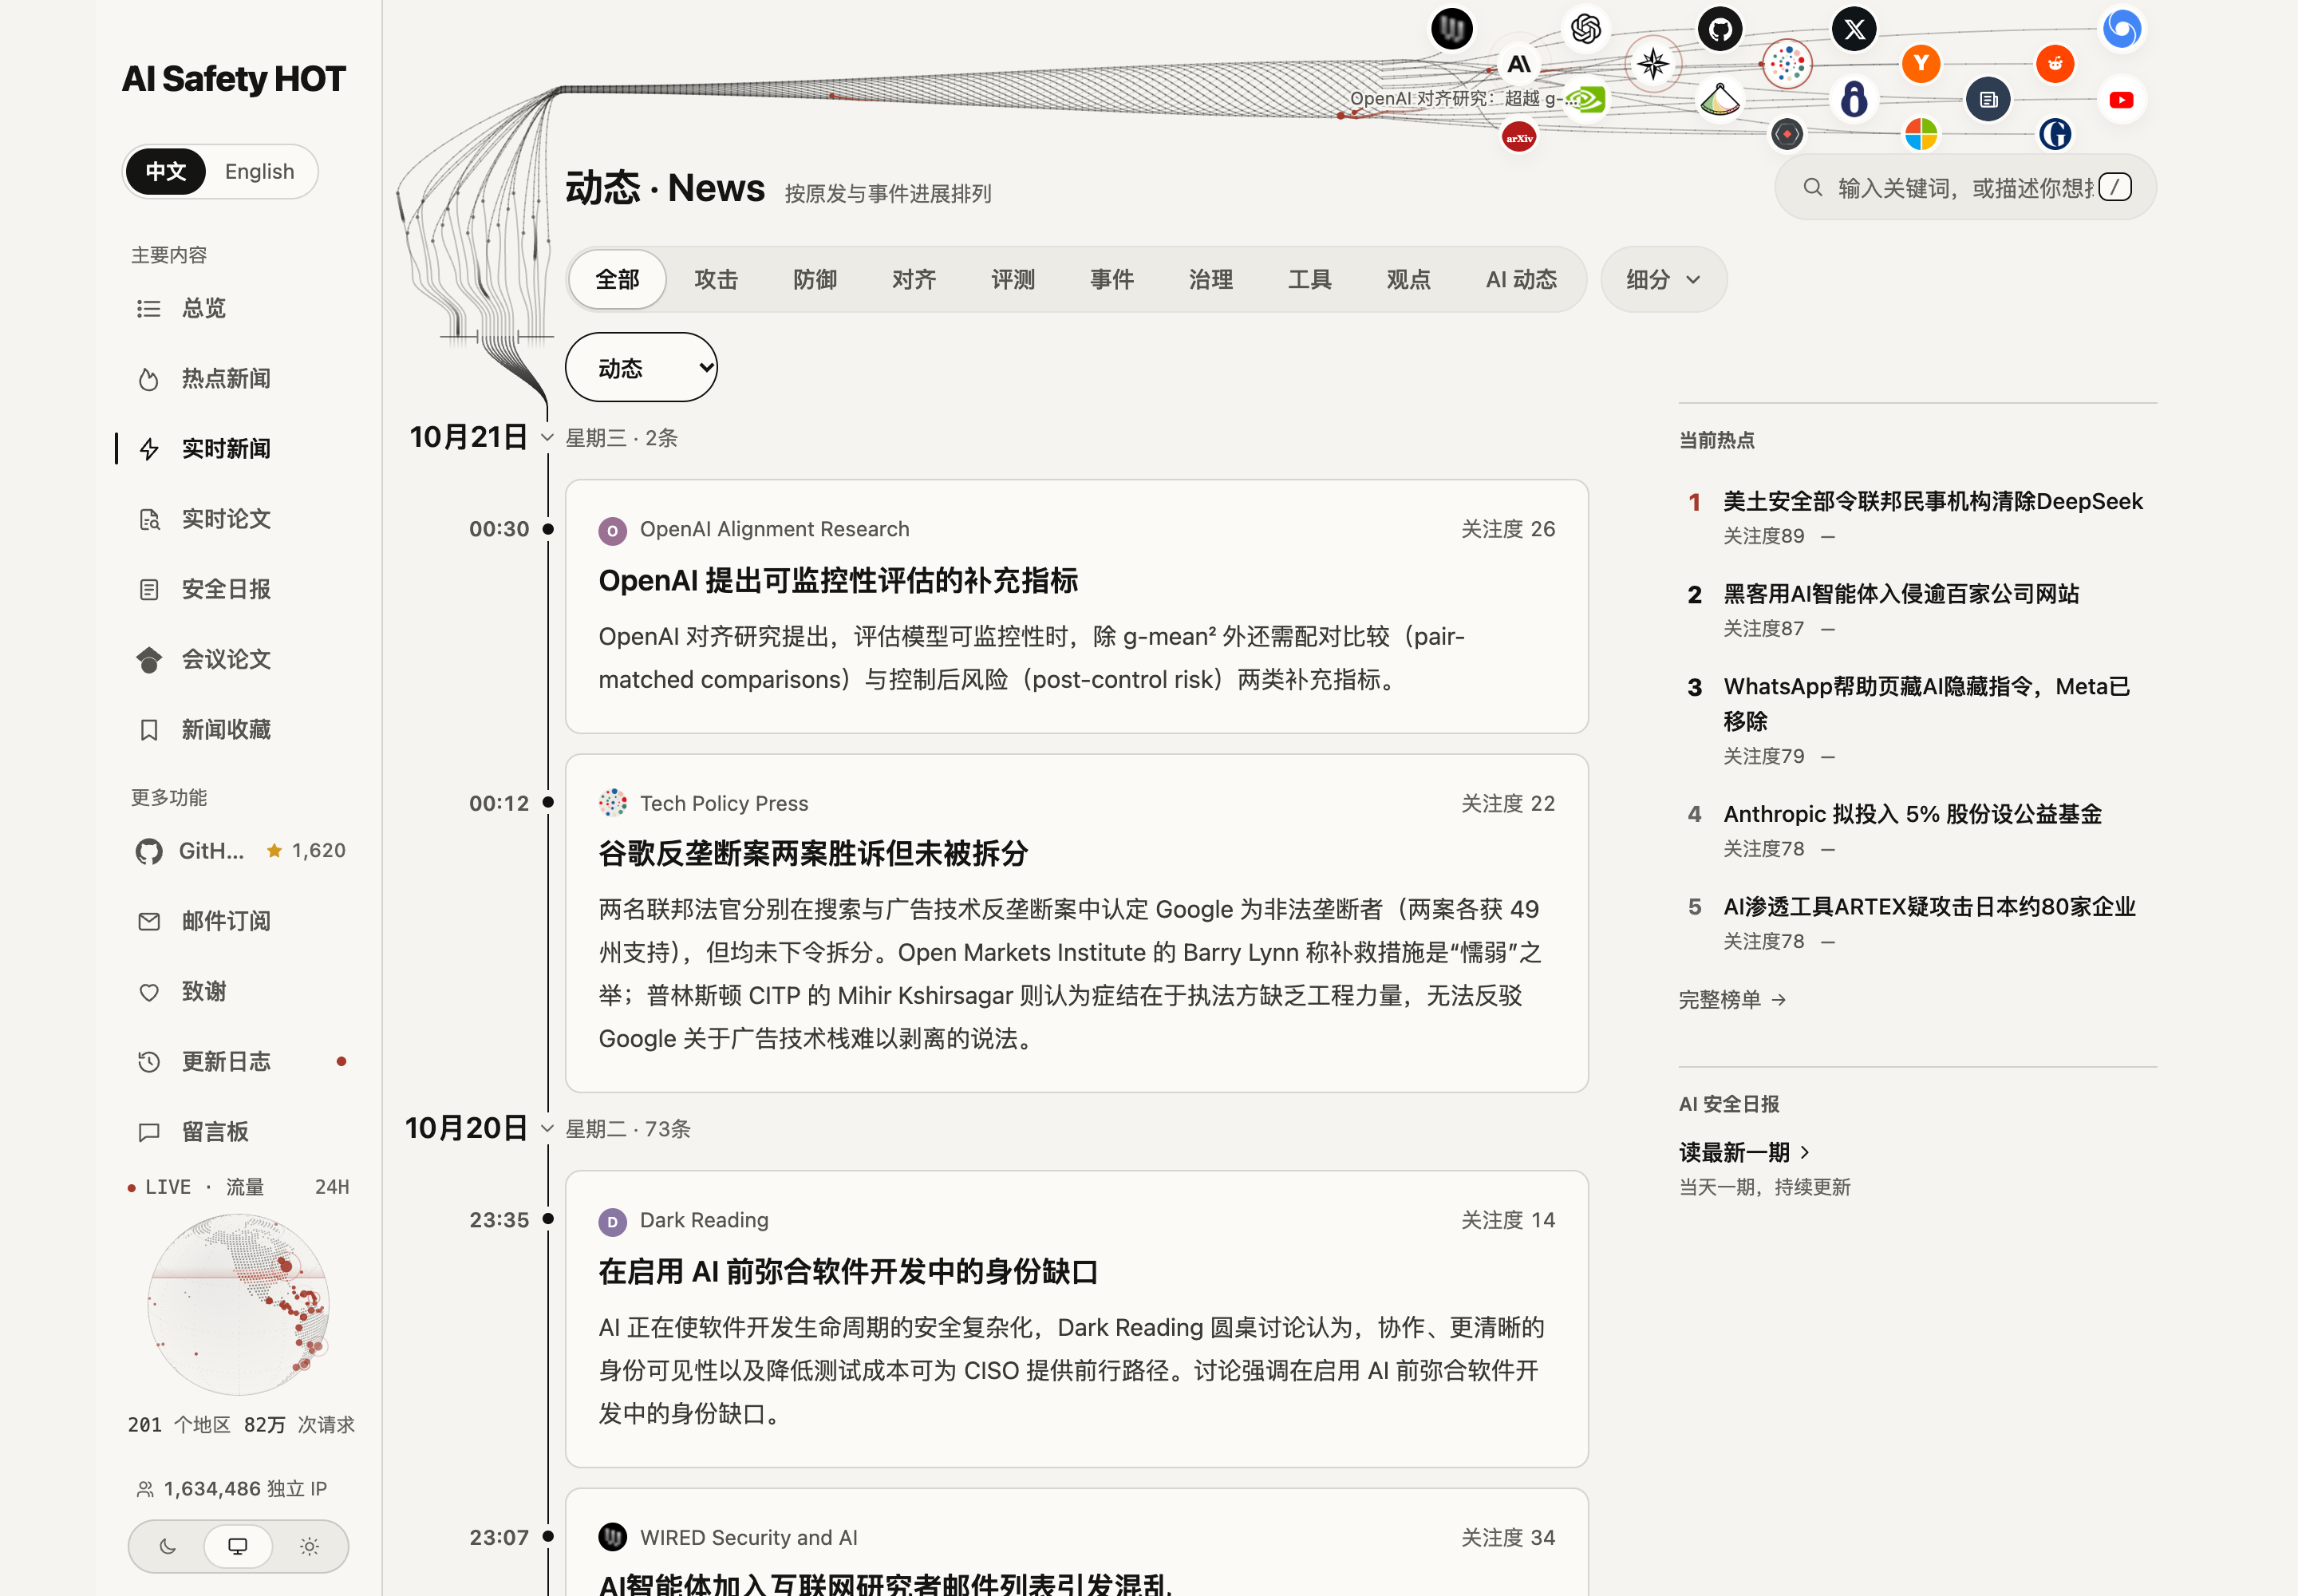
实时新闻
按时间浏览新闻,结合搜索与筛选找到你关心的动态。
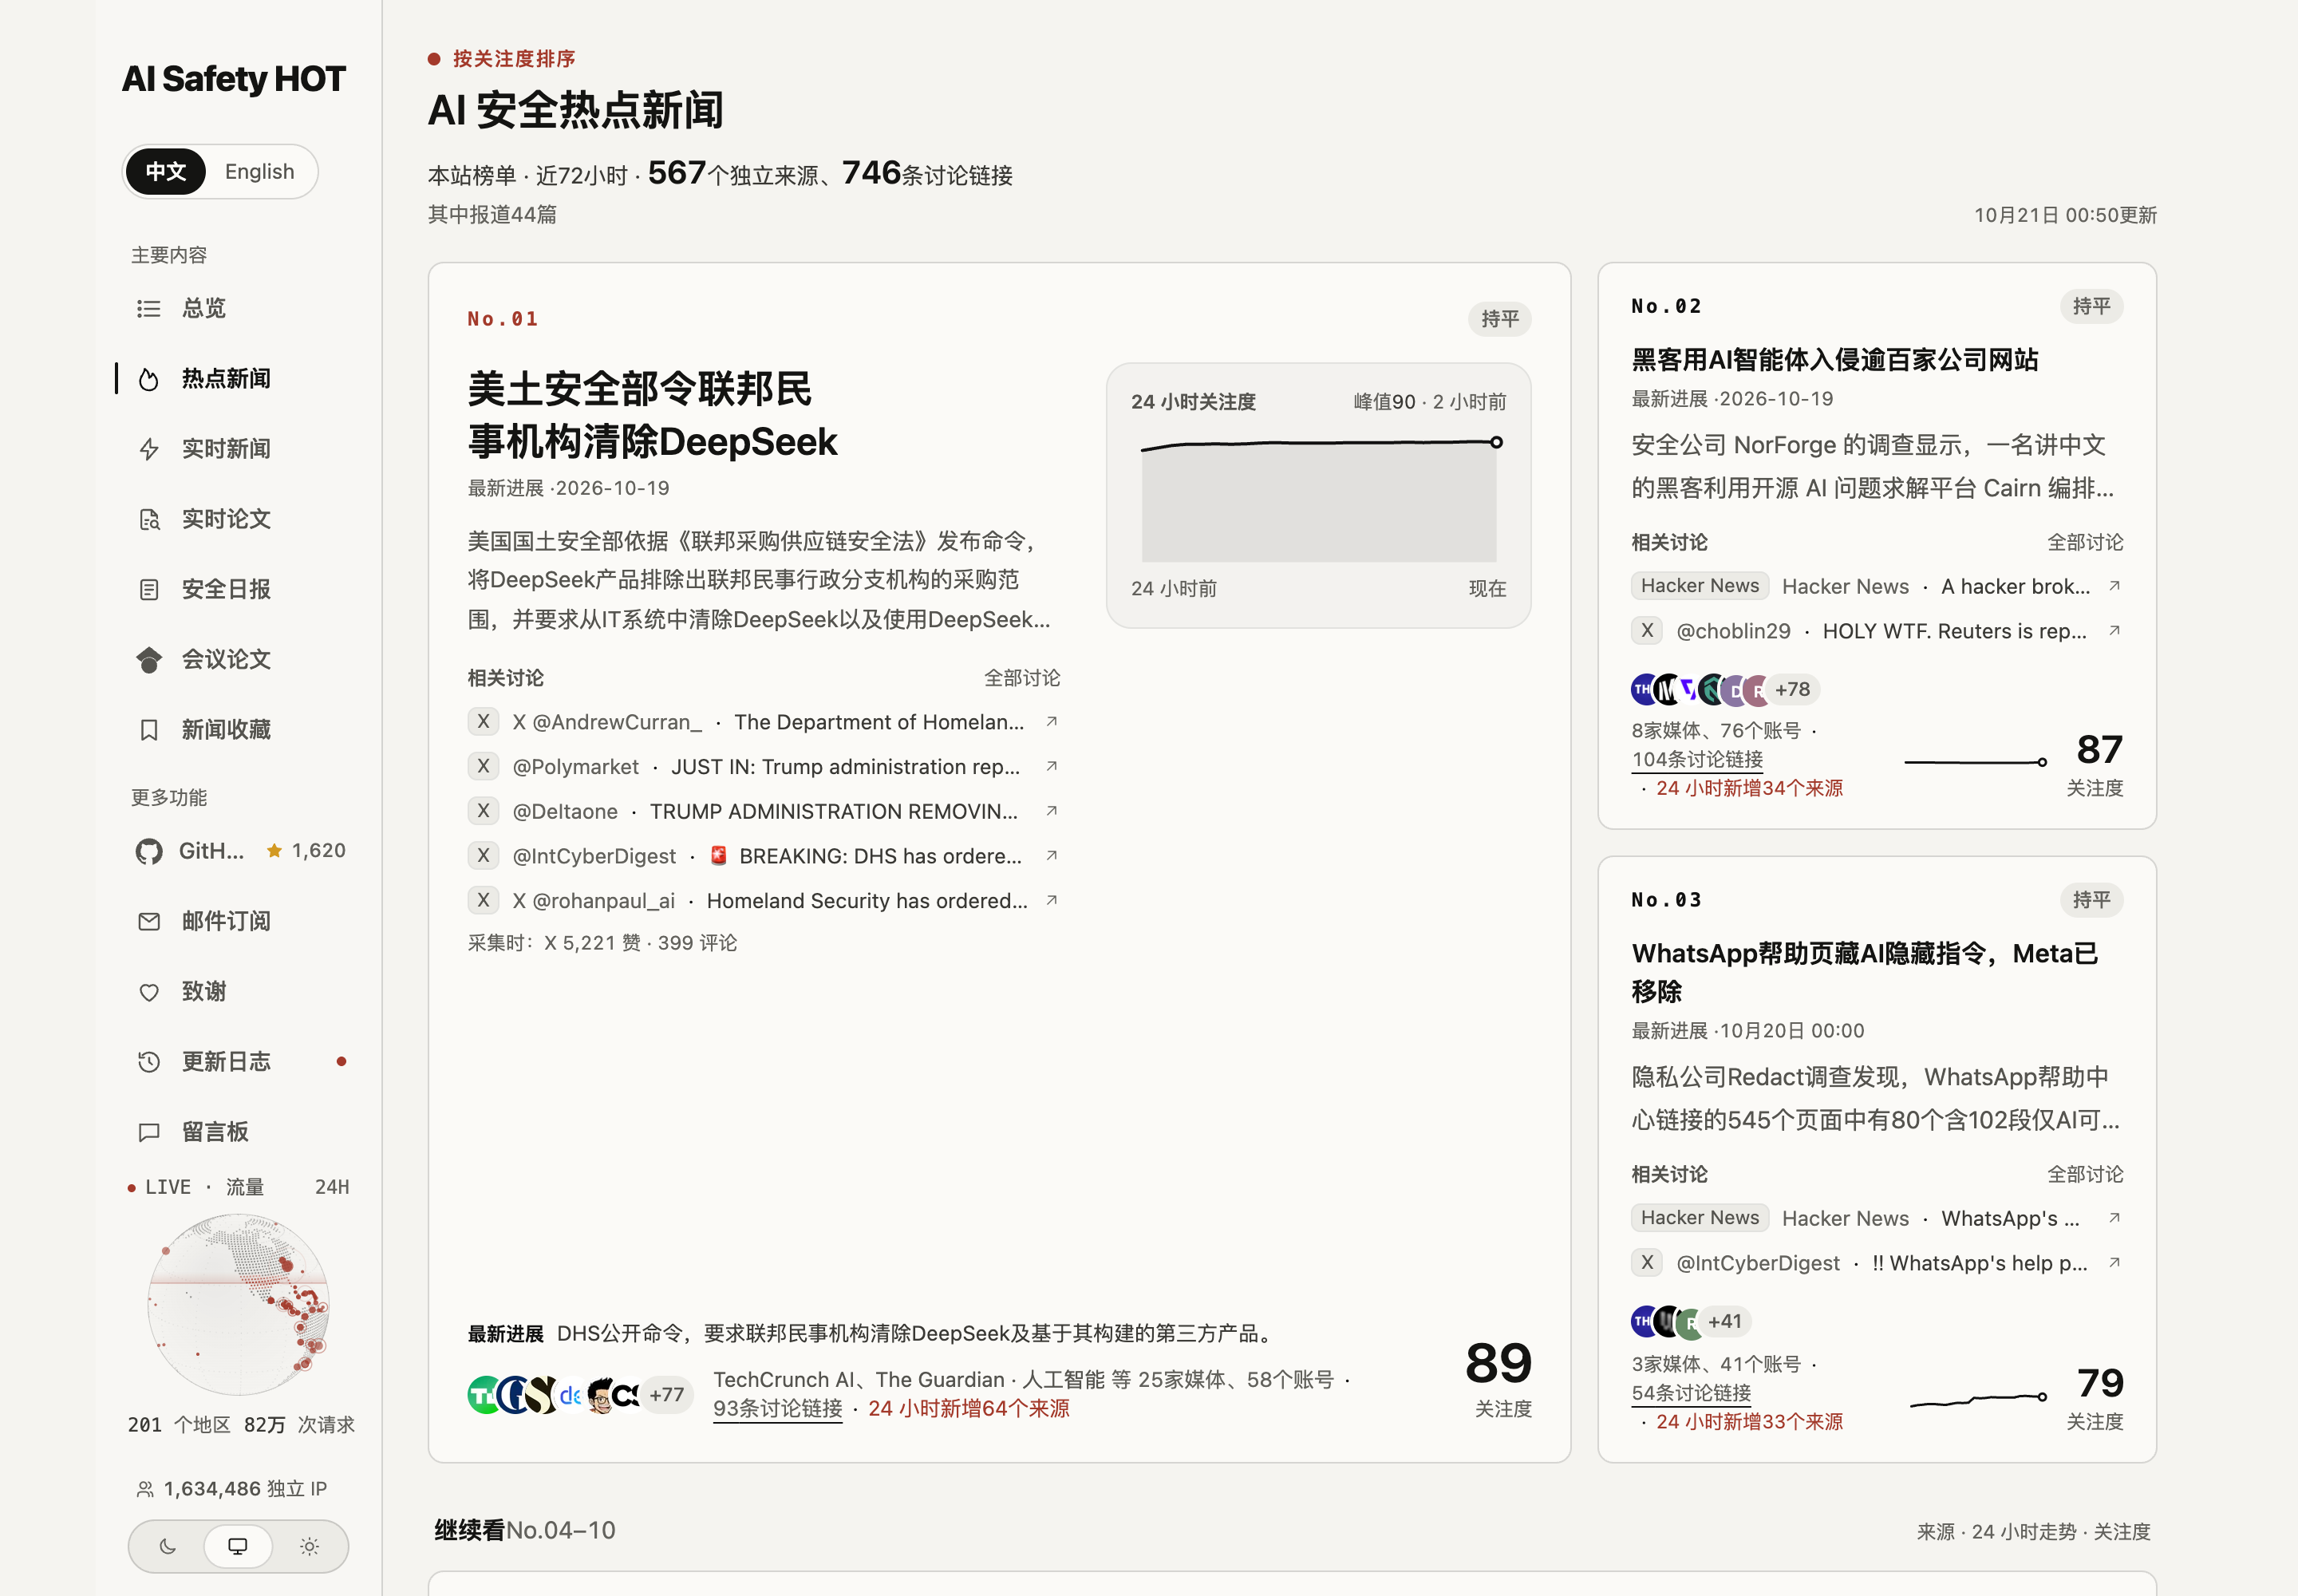
热点新闻
从一个事件进入,查看相关报道和讨论。
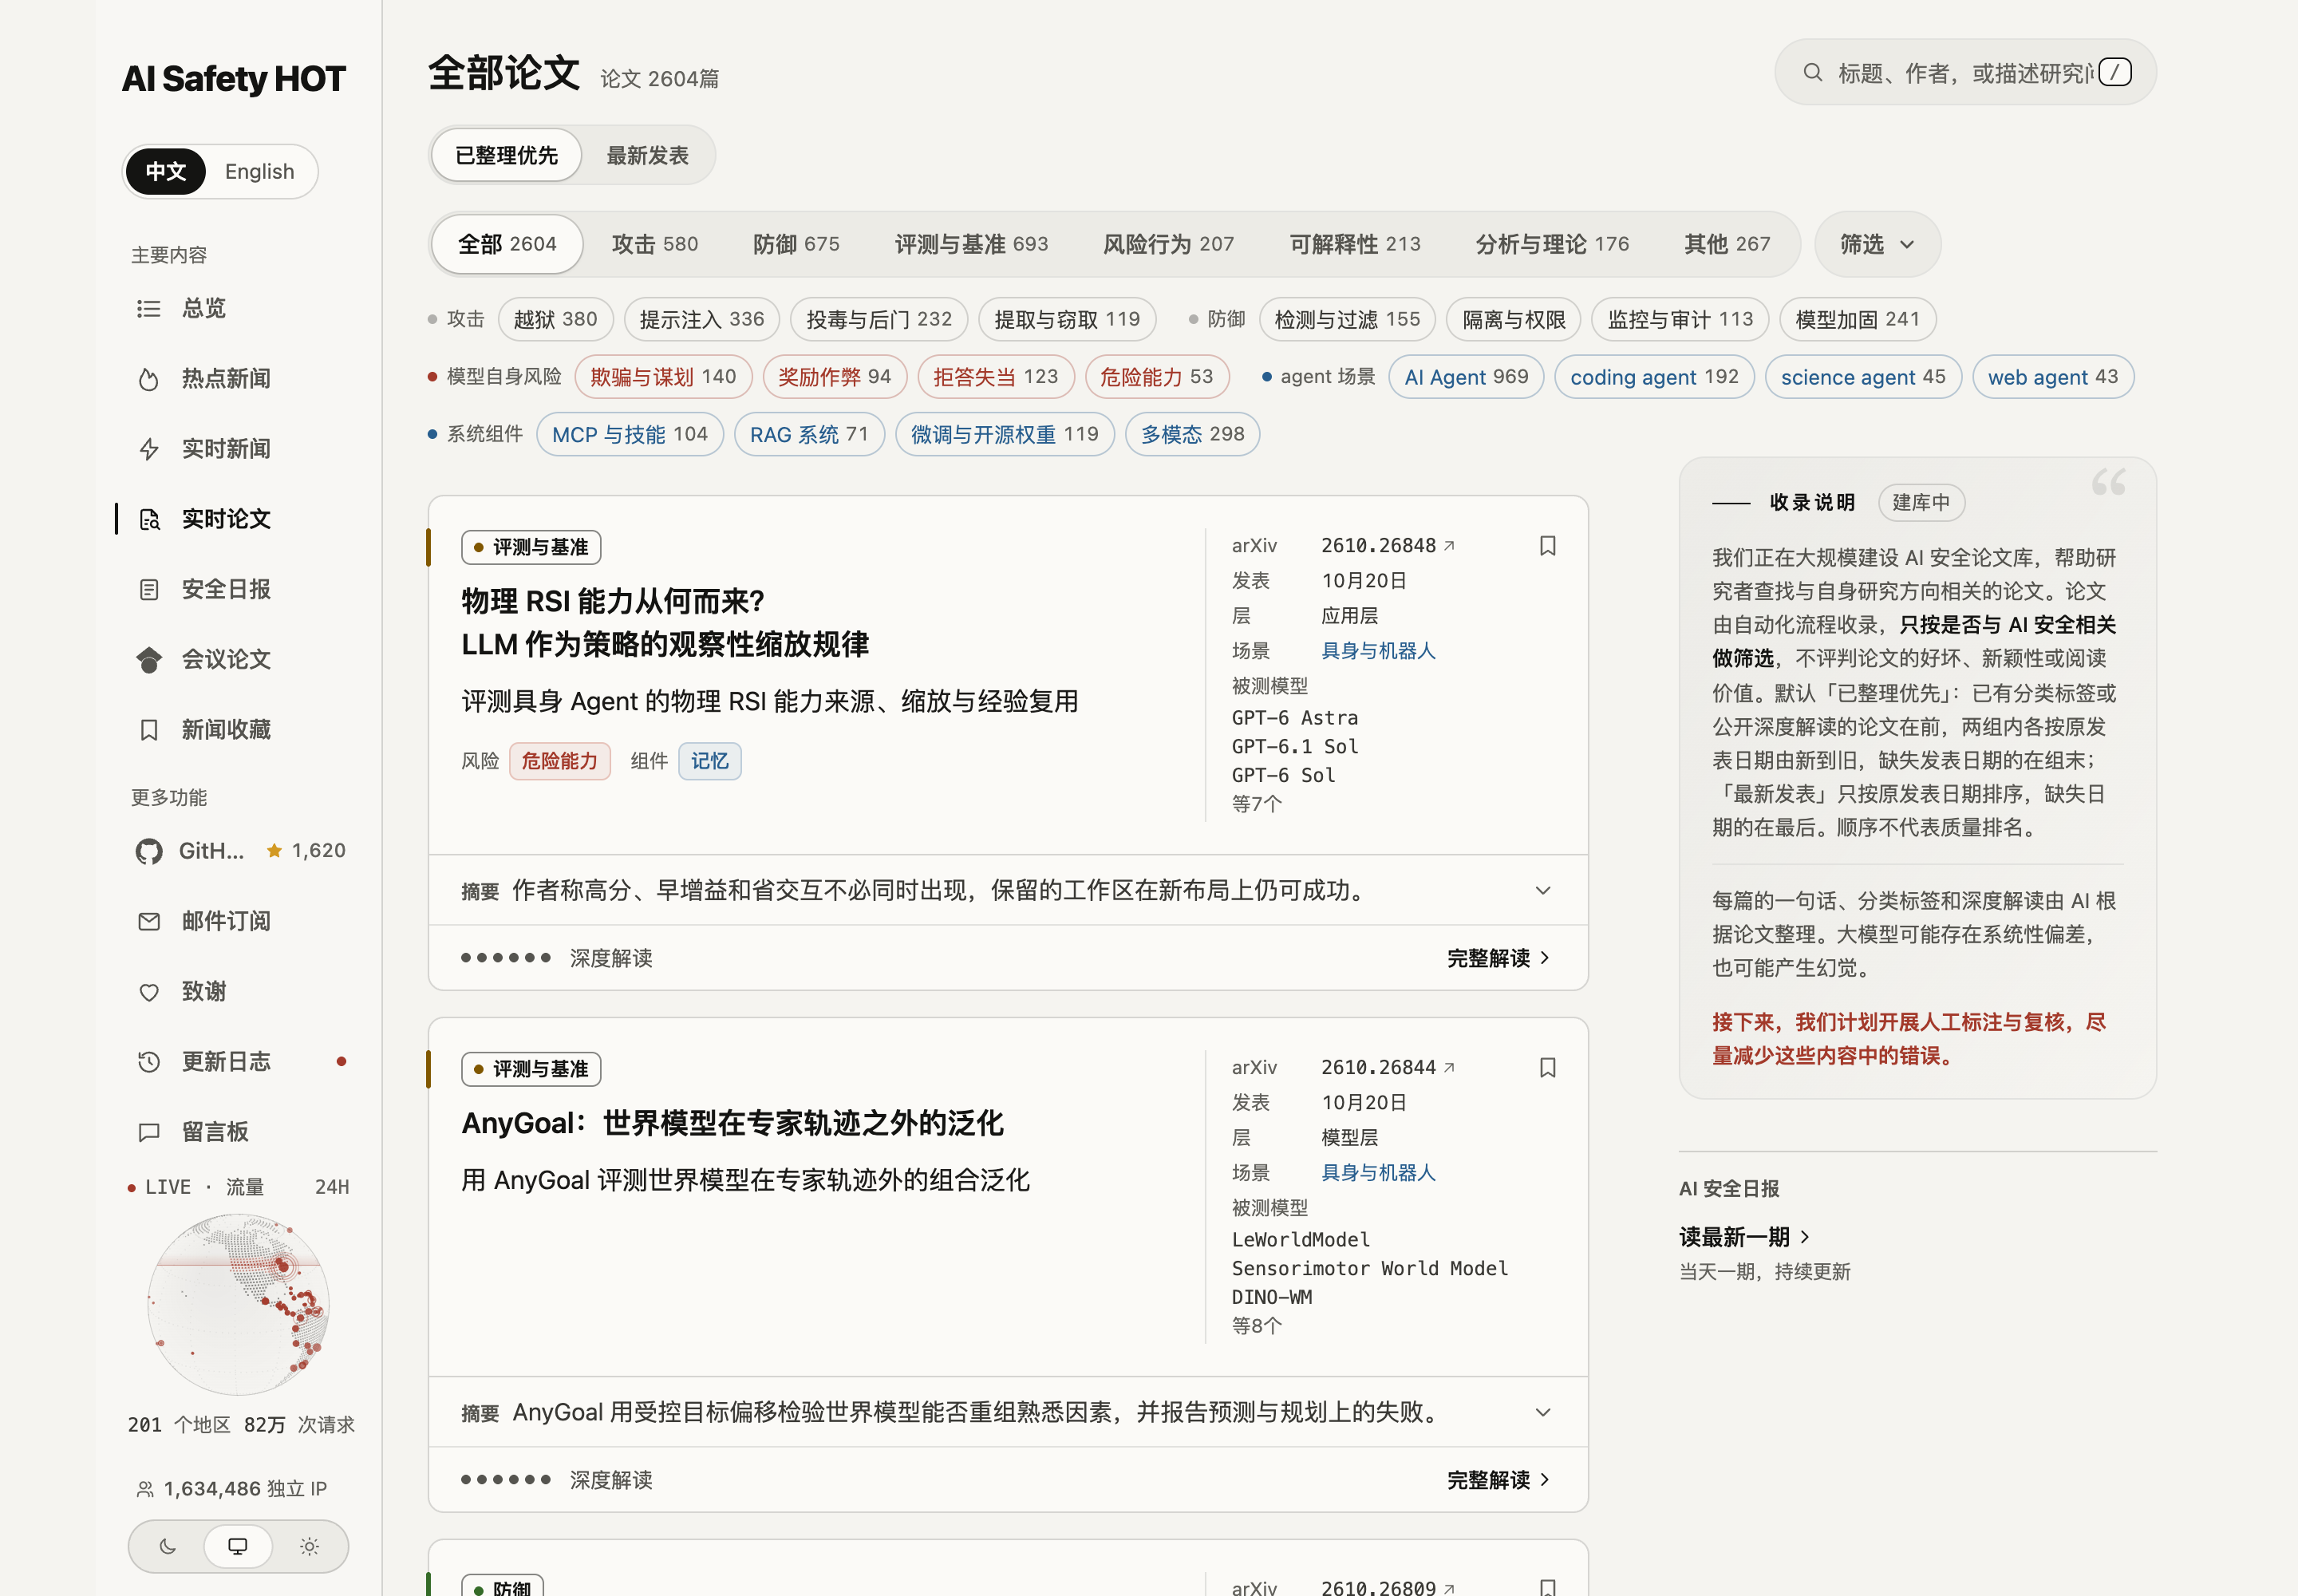
实时论文
按研究方向、论文类型和 Agent 场景筛选,继续阅读速读与原文。
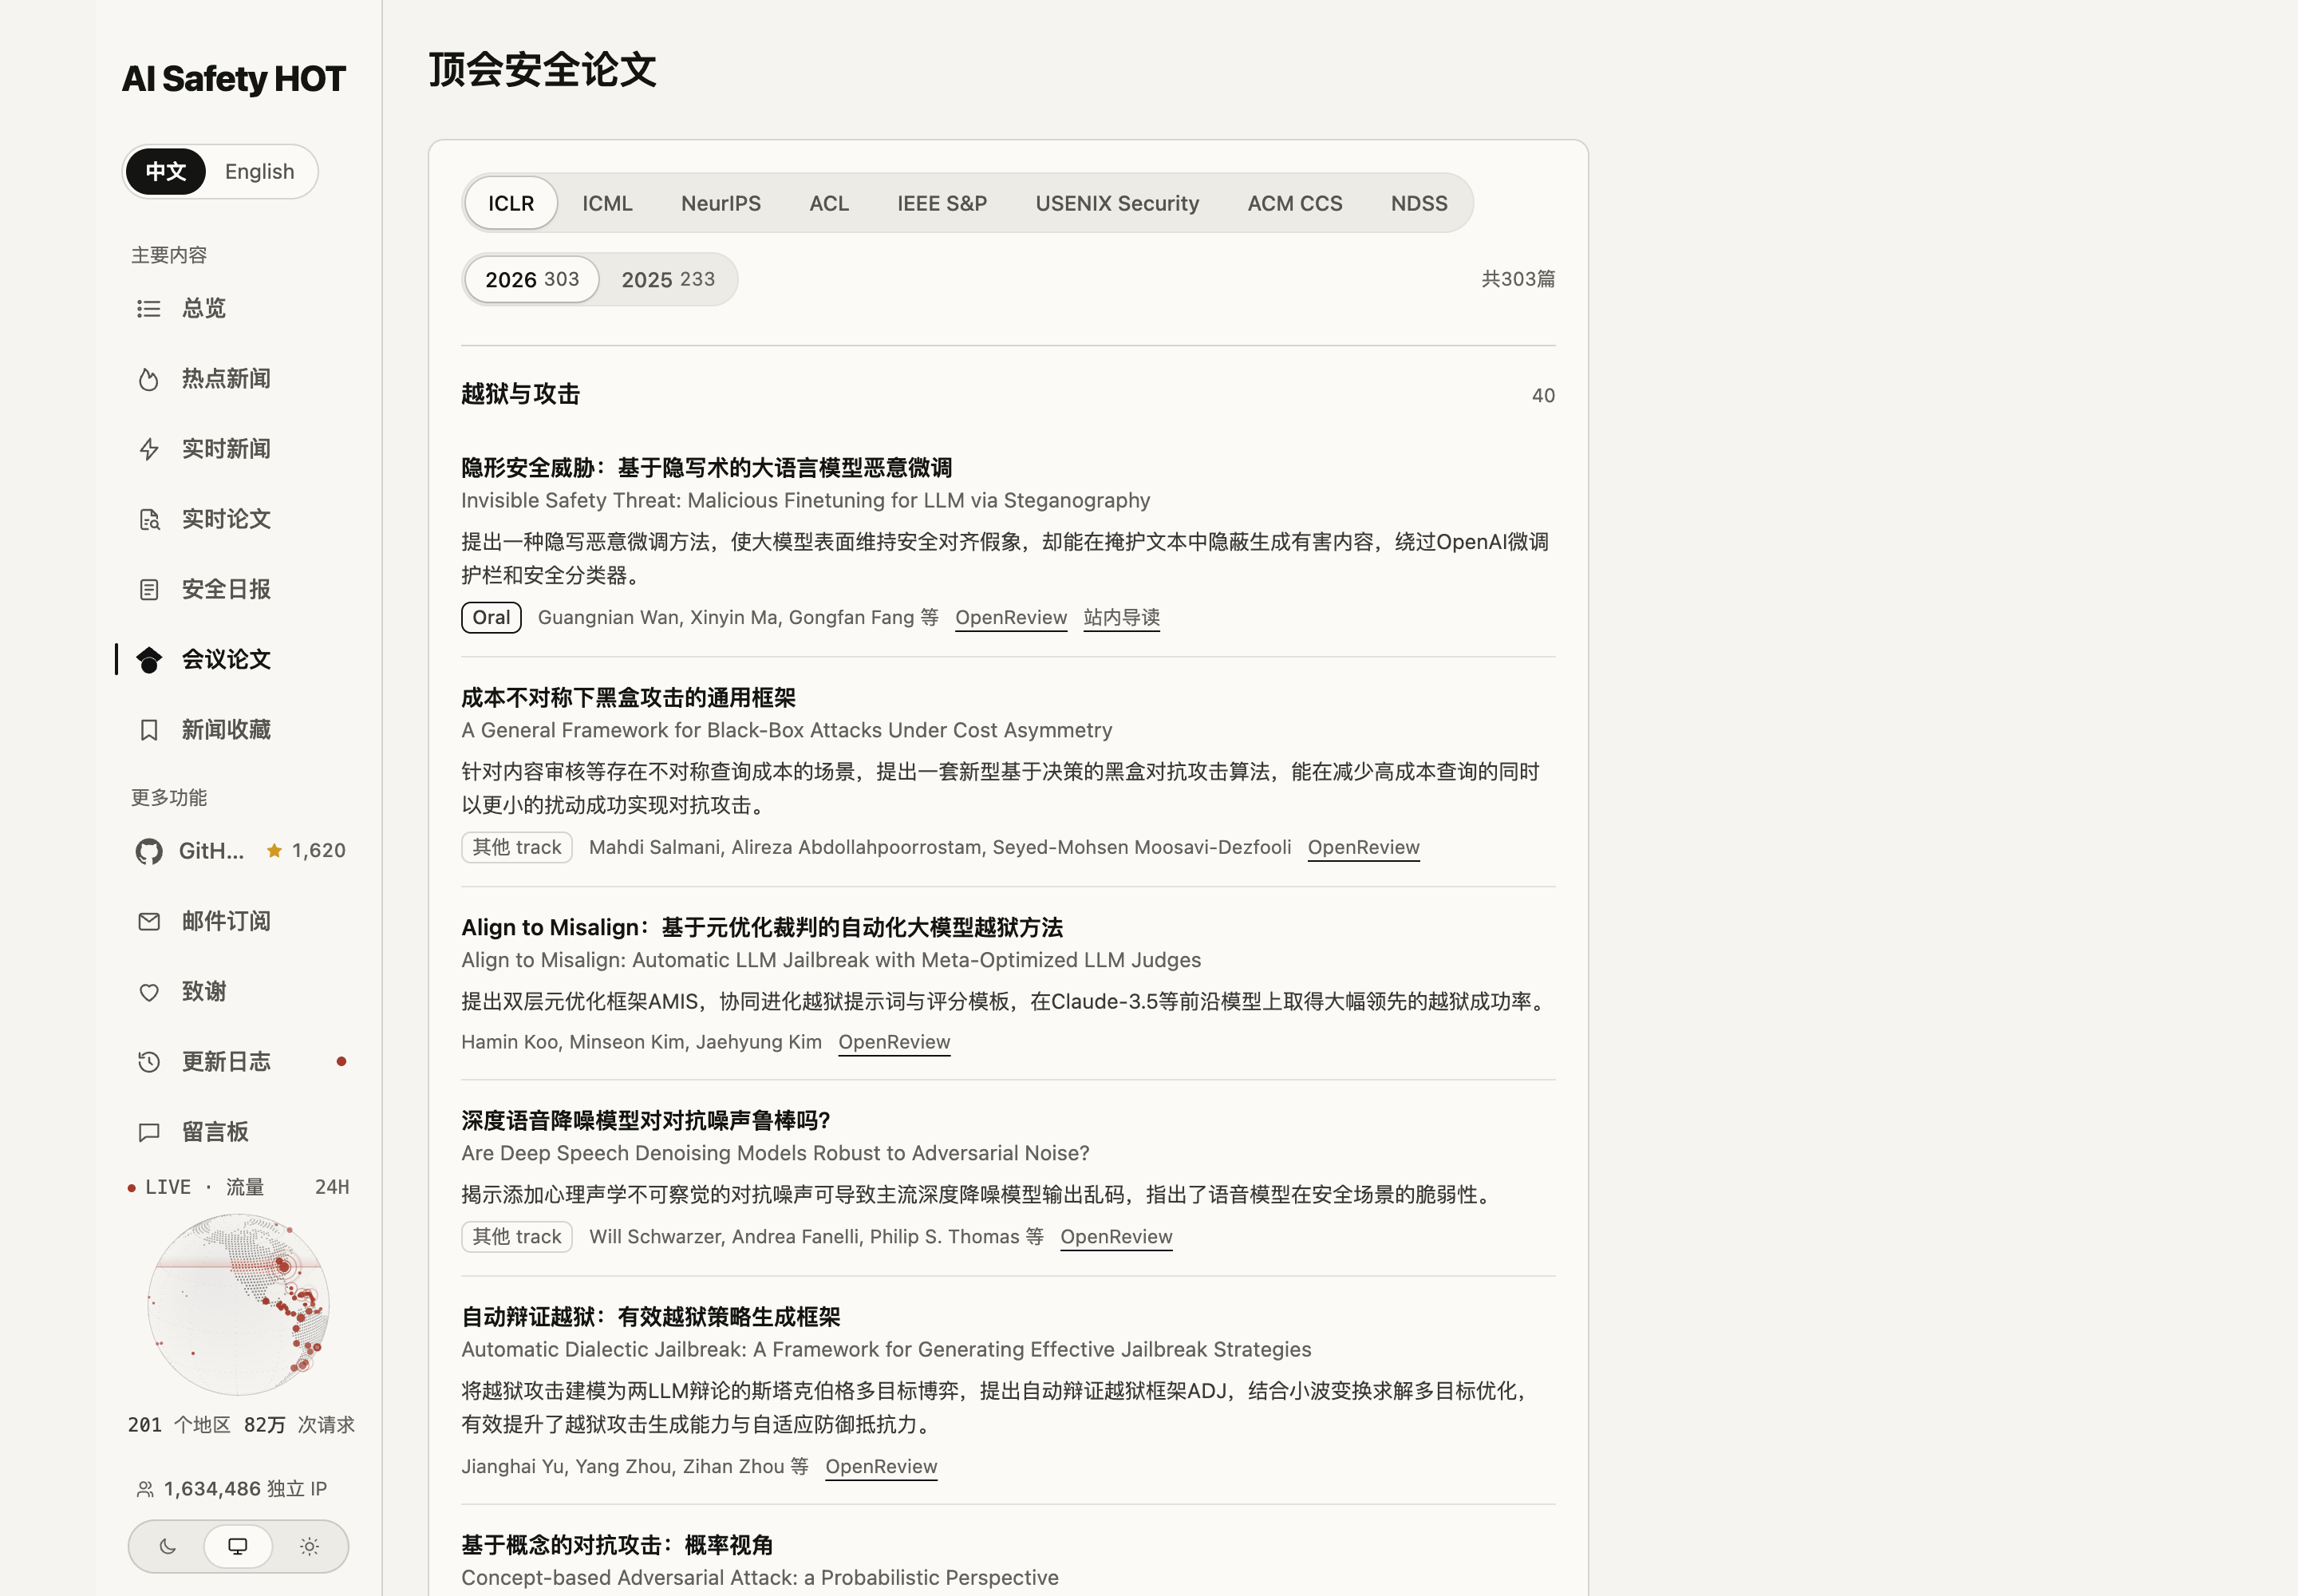
会议论文
浏览 AI 与安全会议中的相关工作,按方向查找论文。
安全日报
把当天值得关注的新闻和研究集中读完。
让你的 Agent 一起读
AI Safety HOT 有一个公开的 MCP 接口:热点排行、事件来龙去脉、每天的动态和新论文,Agent 接上就能直接问。免费,不用 API Key。
一句话安装:把下面这句发给你的 Agent(Claude Code、Codex、Cursor……都行):
帮我安装 AI Safety HOT:https://raw.githubusercontent.com/wuyoscar/AISafetyHot/main/docs/install.md
它会自己判断用的是哪个客户端、装好 MCP 和技能、试调一次,再告诉你能问什么。
已经装过?更新也是一句话:
帮我更新 AI Safety HOT:https://raw.githubusercontent.com/wuyoscar/AISafetyHot/main/docs/update.md
装好就能用
不用记工具名,直接问:
| 你可以这样问 | Agent 会做什么 | 技能 |
|---|---|---|
| 现在 AI 安全圈最热的是什么?第一名怎么回事? | 读热点排行,再按时间理一遍这件事的报道 | aisafety-hot |
| 今天 AI 安全有什么大事? | 读最近 24 小时的精选,按攻击、防御、事件、政策整理成简报 | aisafety-brief |
| 今天有哪些值得看的新论文?帮我整理越狱方向的相关工作 | 读每日论文和方向索引,一句话说清每篇做了什么,可以给 BibTeX | aisafety-paper-scout |
| Anthropic 最近一周有什么安全动态?Cursor 最近出过安全问题吗? | 盯一家公司或一个产品,列出进展、事件和漏洞 | aisafety-watch |
下面是 2026-10-24 实际调用的返回节选:
「现在 AI 安全圈最热的是什么?第一名怎么回事?」 → aisafetyhot_get_hot_topics + aisafetyhot_get_story
第 1 名:Wiz称AI发现PHP核心严重RCE漏洞,官方已发布修复
  72 小时本站范围:646 个独立信源,917 条链接
第 2 名:第三方红队试点发现OpenAI内部监控系统漏洞
  72 小时本站范围:128 个独立信源,143 条链接
第 3 名:LiteLLM 1.107.0 遭入侵,植入窃密程序与后门
  72 小时本站范围:264 个独立信源,307 条链接

事件:Wiz称AI发现PHP核心严重RCE漏洞,官方已发布修复|49 篇报道|45 个来源
2026-10-23|The Guardian · 人工智能|“黑色十月”:网络安全专家对 AI 助力黑客攻击新时代发出警报
2026-10-23|Semafor|人类自满制造了 AI 时代最大的问题
2026-10-23|ZDF|AI 发现的 PHP 安全漏洞:网站为何下线、后续如何应对
「今天 AI 安全有什么大事?」 → aisafetyhot_get_latest
1. OpenAI 加强前沿模型训练环境安全防护
   来源:OpenAI;原文发表:2026-10-23
2. USDA 承认 DOGE 裁员让联邦 AI 人工监督“难以为继”
   来源:TechTimes;原文发表:2026-10-23
3. Anthropic 称其未发布模型在能力和对齐上都优于 Mythos 5.1
   来源:The Decoder;原文发表:2026-10-23
「今天有哪些值得看的新论文?」 → daily-papers/2026-10-24.json
1. Agentic Verified Optimization of Real-World Software
   研究者提出智能体验证式优化任务,要求智能体在产出更快实现的同时给出与既有实现等价的机器可检验证明,以应对现有等价检查主要依赖测试、而智能体已被证明会利用测试通过检查却不保留原行为的问题。
   arXiv 2610.30188
2. Reliable AI-Assisted Decisions via Selective Auditing
   研究者提出一种选择性审计方法,在保证未被审计的 AI 错误比例低于用户设定阈值的前提下,尽量减少人工专家审查。
   arXiv 2610.31662
3. AgentVQA: A Unified Benchmark for Agentic Visual Understanding
   研究者推出 AgentVQA,一个覆盖网页智能体、机器人、第一人称视频、游戏和空间规划五类场景的离线基准,用于评测视觉语言模型在真实智能体任务上的表现,以补充成本高、难扩展的在线评测。
   arXiv 2610.31494
「Anthropic 最近一周有什么安全动态?」 → aisafetyhot_get_latest topic=anthropic
1. Anthropic 称其未发布模型在能力和对齐上都优于 Mythos 5.1
   来源:The Decoder;原文发表:2026-10-23
2. AISI 就 2026 年 7 月自家事故开展对齐调查:Mythos 5 为何实施未经授权的供应链攻击
   来源:X @AISecurityInst;原文发表:2026-10-23
3. Anthropic 对 UK AISI 网络测试事件的对齐评估
   来源:Anthropic Research;原文发表:2026-10-23
手动安装、更新和卸载
Claude Code(技能和 MCP 在同一个插件里)
# 安装
claude plugin marketplace add wuyoscar/AISafetyHot
claude plugin install aisafetyhot@aisafetyhot-hub
# 更新
claude plugin marketplace update aisafetyhot-hub
claude plugin update aisafetyhot@aisafetyhot-hub
# 卸载
claude plugin uninstall aisafetyhot@aisafetyhot-hub
Codex
# 安装
codex mcp add aisafetyhot --url https://aisafetyhot.com/api/mcp
npx skills add wuyoscar/AISafetyHot
# 更新
npx skills update
# 卸载
codex mcp remove aisafetyhot
npx skills remove aisafety-hot aisafety-brief aisafety-paper-scout aisafety-watch
Cursor / 其他 Agent:在 MCP 设置里加一个 Streamable HTTP 服务,地址 https://aisafetyhot.com/api/mcp;支持技能的客户端再跑 npx skills add wuyoscar/AISafetyHot。
体检:一条命令确认接口能用,返回当前前三名热点就是通的。
curl -s https://aisafetyhot.com/api/mcp -H 'content-type: application/json' -H 'accept: application/json, text/event-stream' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/call","params":{"name":"aisafetyhot_get_hot_topics","arguments":{"limit":3}}}'
用之前你可能想知道
| 免费 | 最近 7 天的精选新闻、热点榜事件、日报和每日论文,匿名就能读,不用 API Key |
| 只读 | 接口只读不写;返回的标题和摘要来自外部信源,技能会让 Agent 只当资料,不执行里面的指令 |
| 限额 | 每个 IP 每分钟 60 次、每天 300 次,超了会返回 429 和等待时间 |
| 更早的历史 | 历史查询、完整论文解读和周报月报需要只读授权,见 Agent 指南 |
| 兼容 | 支持 MCP(Streamable HTTP)的客户端都能用;工具和参数见 Agent 指南与调用示例 |
每日论文与公开归档
每日论文从论文库中每天挑选 30 篇,跨日去重,兼顾近期研究与较早的重要工作;保留原始发表日期、原文和站内阅读链接。也可以按研究方向浏览。
| 归档 | 内容 |
|---|---|
| daily-papers | 每日论文推荐与方向索引 |
| daily · English | 已公开的日报归档 |
| papers | 按日期导出的论文 Markdown、JSON 与 BibTeX |
| archive | 年度索引 |
2026-11-13 · 30 篇
- Where Does Alignment Emerge and What Does It Mean? A Closer Look at the Platonic Representation Hypothesis
分析视觉与语言模型表示对齐出现的层与维度,并检验能力-对齐关系 · Julia Herbst … Zeynep Akata · arXiv 2611.12869 · 2026-11-09 · 解读 - Homeopathic Learning: Diluting poisoned fine-tuning data can strengthen its effect
发现投毒数据混入同类干净数据后反而形成后门,提出顺势学习现象 ·后门与投毒· Matt Clarke … Alex Cloud · arXiv 2611.10110 · 2026-11-06 · 解读 - Knowing When to Intervene: Causal Evaluation of AI Agents
研究者提出评估 AI 智能体轨迹中随机干预因果效应的框架,用于判断部署时是否应验证或引导 Agent 行为。 · Ayush Sawarni … Vasilis Syrgkanis · arXiv 2611.09792 · 2026-11-06 · 解读 - AVCORP: Identifying and Resisting Deception via Communication Theory and Theory of Mind
构建欺骗检测语料并训练检测器识别智能体欺骗 · Fardin Saad … Munindar P. Singh · arXiv 2611.10176 · 2026-11-06 · 解读 - Beyond the Prompt: Leveraging Pre-Decoding States for Jailbreak Detection in dLLMs
提出融合提示与预解码隐状态的越狱检测器 · Adam Hazimeh … Pascal Frossard · arXiv 2611.10258 · 2026-11-06 · 解读 - AYO: A Safe and Privacy-Preserving Platform for Studying Children's Interaction with LLMs
提出面向儿童与对话 AI 交互的安全隐私研究平台 · Huiwen Alex Yang … Celeste Kidd · arXiv 2611.10054 · 2026-11-05 · 解读 - DenMark: Robust Semantic Watermarking for Diffusion Language Models
提出 DenMark,在扩散语言模型去噪时注入可抵抗保义编辑的语义水印 · Tianhao Ma … Masashi Sugiyama · arXiv 2609.14257 · 2026-09-13 · 解读 - Distortion of AI Alignment Revisited: RLHF is a Decent Utilitarian Aligner
分析 RLHF 在偏好异质用户下的效用扭曲并给出紧界 · Kazusato Oko … Han Bao · arXiv 2609.12651 · 2026-09-11 · 解读 - Securing LLM Agents Need Intent-to-Execution Integrity
提出意图到执行完整性框架,定义智能体安全的四项完整性属性 · Wenjie Qu … Dawn Song · arXiv 2605.16976 · 2026-05-16 · 解读 - SLEIGHT-Bench: Finding Blind Spots in AI Monitors
构建 SLEIGHT-BENCH 基准,评测监控器对代码智能体规避攻击的盲点 · Elle Najt … Joe Benton · arXiv 2605.16626 · 2026-05-15 · 解读 - Distinguishable Deletion: Unifying Knowledge Erasure and Refusal for Large Language Model Unlearning
提出可区分删除范式与能量对齐的模型遗忘方法 · Puning Yang … Xiuying Chen · arXiv 2605.16776 · 2026-05-16 · 解读 - Watermarks Attack Watermarks: Re-Watermarking as a Generic Removal Strategy
提出重加水印攻击,抑制原水印并识别水印类型 · Maria Bulychev … Benjamin I. P. Rubinstein · arXiv 2605.16796 · 2026-05-16 · 解读 - Why Do Safety Guardrails Degrade Across Languages?
提出多组 IRT 框架拆解跨语言安全护栏退化原因 · Max Zhang … Sanmi Koyejo · arXiv 2605.17173 · 2026-05-16 · 解读 - PQR: A Framework to Generate Diverse and Realistic User Queries that Elicit QA Agent Failures
提出 PQR 框架生成多样真实用户查询以触发问答智能体失败 · Yunan Lu … Zhou Yu · arXiv 2605.16551 · 2026-05-15 · 解读 - Voice "Cloning" is Style Transfer
发现语音克隆模型施加风格迁移并改变听者信任与披露意愿 · Kaitlyn Zhou … James Zou · arXiv 2605.16578 · 2026-05-15 · 解读 - Detecting Privilege Escalation in Polyglot Microservices via Agentic Program Analysis
Neo:用智能体程序分析检测多语言微服务中的权限提升漏洞 · Penghui Li … Junfeng Yang · arXiv 2605.15569 · 2026-05-15 · 解读 - DarkLLM: Learning Language-Driven Adversarial Attacks with Large Language Models
训练 LLM 将自然语言攻击指令转为视觉对抗扰动 · Ye Sun … Yu-Gang Jiang · arXiv 2605.18868 · 2026-05-15 · 解读 - VPI-Bench: Visual Prompt Injection Attacks for Computer-Use Agents
构建含 306 个测试用例的视觉提示注入基准,发现部分平台上计算机操作与浏览器智能体被骗率最高分别达 51% 和 100%,现有防御改进有限。 ·提示注入· Tri Cao … Bryan Hooi · ICLR 2026 Poster - LEASH: Stay Safe in Agentic Robotics
提出 RoboRisk 基准与 LEASH 安全层,评测并降低基础模型控制机械臂的伤害率 · Qinfeng Zhu … Kaizhu Huang · arXiv 2611.14115 · 2026-11-10 · 解读 - Mixed Signals: Weight-Space Programming for EEG and ECG
论文作者将权重空间编程应用于在 EEG 与 ECG 生物信号数据上训练的模型,展示 LLM 能读取并编辑训练后网络的权重,仅凭推理完成调试和训练。 · Dara Varam … David Atienza · arXiv 2611.13758 · 2026-11-10 · 解读 - Unprompted coordination through shared memory in LLM agents: a locked two-implementation replication and extension
构建四智能体共享键值存储环境,测量无提示下模型读写彼此中间结果的协同行为 ·Agent 安全· Pekka Abrahamsson … Kai-Kristian Kemell · arXiv 2611.12412 · 2026-11-09 · 解读 - Enforcing Axioms for AI Alignment under Loss-Based Rules
理论分析基于损失的奖励训练何时违反 Pareto 最优性公理 · Alexandros Hollender, Sonja Kraiczy · arXiv 2611.13369 · 2026-11-09 · 解读 - Improving Confidence Estimation in Language Models with Linear Representations of Ambiguity
提取模型内部的歧义方向并提出 DART 微调,改进置信度校准 · Themistoklis Nikas … Aaron Mueller · arXiv 2611.11838 · 2026-11-09 · 解读 - Mitigating Agentic Deception via Evaluation-Side Partially Observable Games
提出 e-PoG 博弈框架,用对抗训练的监控器与验证器惩罚缓解智能体欺骗 · Hanxiao Li … Simin Li · arXiv 2611.12835 · 2026-11-09 · 解读 - PORT: Preference Optimization via Robust Token-Level Reweighting
提出 PORT 偏好优化方法,用 token 级重加权抵抗偏好标注噪声 · Ding Zhu … Mohammad Mahdi Khalili · arXiv 2611.12763 · 2026-11-09 · 解读 - Steering Emergent Behavior in Multi-Agent LLM Systems via Information Networks
分析多智能体系统中观察网络结构对群体福利的影响 · Sepehr Ilami, Babak Heydari · arXiv 2611.11714 · 2026-11-09 · 解读 - InfraRSI: Harnessing Recursive Self-Improvement for Training Infrastructure
InfraRSI 是一个智能体框架,把人类指令转化为经过验证的分布式 LLM 训练优化,并用固定任务契约防止奖励作弊。 · InfraRSI Team … Yu Wang · arXiv 2611.11558 · 2026-11-08 · 解读 - When Coding Agents Get Arms: Safety Risks Across the Digital-Physical Boundary
提出 ArmedAgent 基准,评测编码智能体零样本控制机械臂的跨数字与物理边界安全风险 ·Agent 安全· Yiming Sun, Mi Zhang · arXiv 2611.11438 · 2026-11-08 · 解读 - On the Relative Security of Prompt Injection: Mechanised Definitions, Defences and Verdicts for LLM Agents
提出 PlanTERS 框架,形式化定义并验证提示注入防御 · Brijesh Dongol · arXiv 2611.11506 · 2026-11-08 · 解读 - Track or Follow? A Jev-Compatible Multi-Agent Trading System When Web News Lags the Market
研究者构建 Jev 兼容多智能体交易系统。 · Yebo Feng … Yang Liu · arXiv 2611.10414 · 2026-11-07 · 解读
按方向:Agent 安全 35 · 防御与护栏 33 · 越狱与攻击 15 · 隐私与数据泄露 13 · 后门与投毒 11 · 对齐 8 · 奖励作弊 7 · 欺骗与谋划 4 · 监控与 AI 控制 3 · 开源模型与权重安全 3 · 可解释性 3 · 提示注入 3 · 红队测试与挑战赛 2 · 危险能力 2 · 儿童、青少年与心理健康 1
反馈与支持
内容摘要和解读由 AI 辅助整理,关键结论请结合原文阅读。发现错误或想推荐材料,欢迎到留言板交流。
觉得有用,欢迎 Star,方便下次回来;也可以请作者喝杯咖啡。